Eine Frage aus dem Alltag: „Wie viel haben wir letztes Jahr bei diesem Lieferanten gekauft, was ist davon noch offen, und wie hat sich sein Preisniveau entwickelt?" In der Sage 100 ist das kein großer Akt, aber auch keine Sache von zehn Sekunden. Du gehst in den Kreditor, wechselst in die Umsätze, öffnest eine Auswertung, filterst auf das Jahr, wechselst in die Belege, suchst die offenen heraus und vergleichst dann in einer dritten Maske die Einkaufspreise. Vier, fünf Masken, ein paar Filter, am Ende eine Zahl im Kopf.
Dieselbe Frage an ein Sprachmodell, das Zugriff auf dieselben Daten hat, dauert einen Satz. Und das ist keine Zukunftsmusik, das läuft. Wir haben so etwas gebaut: Einen schmalen Dienst vor der Sage, der ein paar klar umrissene Fragen beantwortet, tokengesichert, ohne dass jemand die Datenbank aufmacht.
Genau an dieser Stelle wird es für die Zukunft von ERP-Systemen interessant. Denn wenn Fragen so beantwortet werden können, stellt sich eine unbequeme Frage: Wofür brauchen wir dann eigentlich noch die Maske?
Was eine Maske eigentlich ist
Eine ERP-Maske ist eine eingefrorene Antwort auf eine Frage, die irgendwann einmal jemand hatte. Jemand hat festgelegt, welche Felder zusammengehören, in welcher Reihenfolge man sie sieht, welche Auswertung daneben liegt und welche nicht. Das Ergebnis ist eine Navigation, die stellvertretend für Dich denkt.
Technisch steckt dahinter mehr, als man vermutet. Eine typische Maske der Sage 100 bringt grob zwischen zwanzig und siebzig Abfragen mit, die sie je nach Register und Aktion abfeuert. Das ist eine Menge vorgedachter Arbeit, und sie ist wertvoll. Sie ist aber eben auch eine Annahme darüber, was Du wissen willst.
Solange Deine Frage in dieser Annahme vorkommt, ist die Maske schneller als jedes Gespräch. Sobald sie danebenliegt, fängt die Klickarbeit an. Und die meisten Fragen, die im Alltag wirklich nerven, liegen daneben.
Was Sprachmodelle daran verändern
Ein Sprachmodell braucht keine Navigation. Es braucht Struktur und Bedeutung. Wenn es weiß, dass in einer Tabelle Kreditoren stehen, in einer anderen deren Belege, und wie beides zusammenhängt, dann muss ihm niemand einen Weg durch fünf Masken bauen. Drei Dinge verschieben sich damit:
- Fragen statt Klicken. Auswertungen, die heute ein Ticket oder eine Individualabfrage auslösen, werden zur Rückfrage im Gespräch. Der Aufwand für eine einmalige Frage sinkt auf nahezu null, und damit stellen Leute plötzlich Fragen, die sie sich vorher gespart haben.
- Vorgänge statt Einzelmasken. Ein Vorgang wie „Angebot aus dieser Anfrage bauen, Preise aus der aktuellen Staffel ziehen, Liefertermin beim Lieferanten prüfen" berührt heute mehrere Programmteile. Für ein Modell ist das eine Abfolge von Werkzeugaufrufen.
- Ausnahmen statt Standard. Der Standardfall läuft in jedem ERP gut. Geld kostet der Rest: Die Sonderkonstellation, für die es keine Maske gibt und bei der heute jemand angerufen wird, der sich auskennt. Genau dort sind Modelle stark, weil sie Zusammenhänge herstellen, statt einem festen Pfad zu folgen.
Warum die Maske trotzdem nicht einfach verschwindet
Jetzt der Teil, den die meisten Beiträge zu diesem Thema weglassen. Es gibt gute Gründe, warum die klassische Oberfläche so schnell nicht abgeschafft wird, und sie sind nicht nostalgisch.
- Eine Buchung muss reproduzierbar sein. Ein Sprachmodell ist von Natur aus nicht deterministisch. Zweimal dieselbe Frage kann zwei Formulierungen ergeben. Für eine Auswertung ist das egal, für eine Buchung nicht. Steuerlich und handelsrechtlich musst Du belegen können, auf welchem Weg ein Wert zustande gekommen ist.
- Masseneingabe ist heute Tastaturarbeit. Wer den ganzen Tag Belege erfasst, ist mit Tabulator und Zehnerblock schneller als mit jeder Konversation. Dieses Argument hat allerdings ein Verfallsdatum, und das sollte man dazusagen: Ob Belege in einigen Jahren überhaupt noch von Hand erfasst werden, steht auf einem ganz anderen Blatt. E-Rechnung, EDI und Belegerkennung nehmen genau diese Arbeit gerade weg. Wo nichts mehr getippt wird, braucht es auch keine schnelle Erfassungsmaske.
- Die Maske ist auch eine Berechtigungsgrenze. Wer keinen Zugriff auf die Maske hat, sieht die Daten nicht. Diese Grenze musst Du bei einem freien Zugang komplett neu ziehen, und zwar sauberer als vorher.
- Vertrauen entsteht über Wiedererkennung. Ein Sachbearbeiter, der seit zwölf Jahren dieselbe Erfassungsmaske bedient, arbeitet darin schnell und fehlerarm. Das gibt man nicht leichtfertig auf.
Diese vier Gründe sind unterschiedlich haltbar, und das ist der interessante Teil. Die Masseneingabe erledigt sich vermutlich von selbst, nur eben nicht durch ein Sprachmodell, sondern durch Formate und Automatisierung. Die Reproduzierbarkeit einer Buchung und die Frage, wer was sehen und auslösen darf, verschwinden dagegen nicht. Die werden eher wichtiger, je mehr Wege in das System führen.
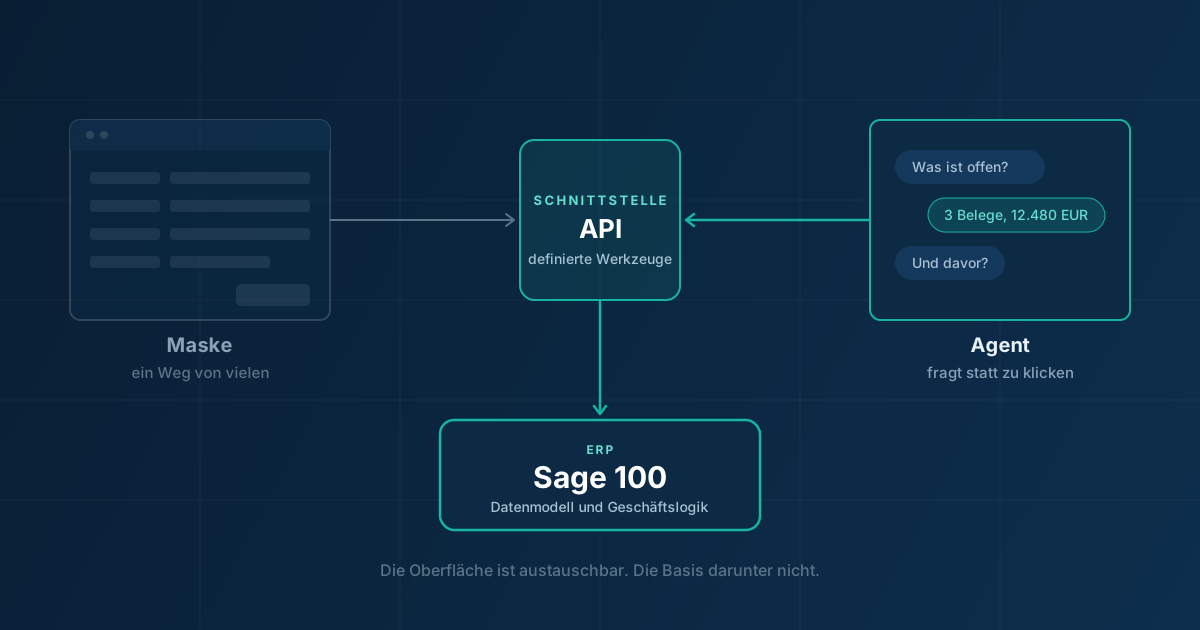
Meine These ist deshalb nicht, dass die Oberfläche verschwindet. Sie verliert ihr Monopol. Aus „die Maske ist das System" wird „die Maske ist einer von mehreren Wegen in das System". Das ist ein Unterschied, aber ein folgenreicher.
Warum die Sage 100 dafür eine gute Basis ist
Und jetzt kommt der Punkt, der mich an dieser Entwicklung wirklich interessiert: Eine gewachsene Sage 100 ist für so eine Zukunft besser vorbereitet als manche moderne Cloud-Lösung mit hübscher Oberfläche und dünnem Unterbau.
Ein Datenmodell, das man erklären kann
Der eigentliche Wert der Sage 100 liegt nicht in der Oberfläche, sondern darunter: Ein relationales Modell, in dem Artikel, Kontokorrente, Belege, Buchungen und Lagerbewegungen sauber getrennt sind und über nachvollziehbare Schlüssel zusammenhängen. Genau das ist das Futter, das ein Modell braucht. Man kann einem Sprachmodell dieses Schema beibringen. Man kann ihm nicht beibringen, was in einem Datentopf ohne Struktur steht.
Geschäftslogik, die nicht in der Maske klebt
Das ist der entscheidende Teil, und er wird oft übersehen. Die Regeln der Sage 100 stecken nicht ausschließlich in der Oberfläche, sondern in einer Objektschicht dahinter, die über den Applikationsserver erreichbar ist. Wer einen Beleg über diese Objekte anlegt und speichert, bekommt dieselben Prüfungen, dieselbe Nummernvergabe und dieselbe Transaktionsklammer wie ein Anwender, der in der Maske auf Speichern drückt.
Das klingt technisch, ist aber der Unterschied zwischen einer tragfähigen Anbindung und einer Zeitbombe. Ein Beispiel: Belegnummern und Schlüssel vergibt die Sage über einen zentralen Mechanismus. Wer stattdessen direkt in die Tabelle schreibt und sich seine Nummer selbst ausdenkt, bekommt keine Fehlermeldung, sondern irgendwann doppelte Schlüssel, und das merkt niemand am selben Tag.
Die Faustregel bleibt dieselbe wie bei jeder Schnittstelle: Lesen darfst Du aus der Datenbank, schreiben nur über die Objekte. Daran ändert ein Sprachmodell gar nichts, es macht die Regel nur wichtiger, weil deutlich mehr Schreibzugriffe automatisiert angestoßen werden.
Metadaten sind maschinenlesbares Wissen
Die Sage 100 beschreibt sich selbst. Masken, Abfragen, Sichten und Felddefinitionen liegen in der Datenbank. Das ist im Alltag eher Ballast, für diesen Zweck aber Gold: Du kannst maschinell auslesen, wie Dein System aufgebaut ist, welche Felder es gibt und was eine Individualentwicklung ergänzt hat. Wer ein Modell anlernen will, hat hier einen sehr guten Ausgangspunkt, und zwar ohne dass jemand eine Dokumentation schreiben muss.
Was heute schon geht
Das ist kein Konzeptpapier, das lässt sich bauen. Wir haben genau diesen Weg ausprobiert und den Zugriff bewusst eng geschnitten:
- Ein schmaler Dienst vor der Sage. Kein Datenbankzugang nach außen, sondern ein Endpunkt, der eine Handvoll definierter Fragen beantwortet. Zugriff über Token, Aufrufe werden protokolliert.
- Feste Abfragen statt freiem SQL. Das Modell bekommt Werkzeuge mit Parametern, nicht eine Konsole. Es kann fragen „Kontenumsatz für Konto X im Zeitraum Y", aber es kann keine Abfrage erfinden, die einen Tabellenscan über Millionen Zeilen auslöst.
- Lesen zuerst, lange. Auswertungen, Status, Verfügbarkeiten. Alles, was schiefgehen kann, ist eine falsche Antwort, und die fällt auf.
- Schreiben nur über die Objektschicht. Und zwar mit demselben Protokoll wie jede andere Automatik: Wer hat was über welches Werkzeug ausgelöst.
Der Unterschied zwischen „das Modell hat Zugriff auf die Datenbank" und „das Modell hat ein paar klar definierte Werkzeuge" ist der ganze Punkt. Im ersten Fall hast Du ein unkalkulierbares Risiko, im zweiten eine Schnittstelle, die sich genauso prüfen lässt wie jede andere.
Wie ich vorgehen würde
- Sammle die Fragen, die heute Klickarbeit sind. Nicht die Visionen, die echten Fragen aus dem Tagesgeschäft. Meist sind es fünf bis fünfzehn, die achtzig Prozent des Ärgers ausmachen.
- Baue je Frage ein Werkzeug. Eine klar definierte Abfrage mit Parametern, dokumentiertem Rückgabeformat und Berechtigungsprüfung. Genau so, wie Du auch eine Schnittstelle zu einem anderen System bauen würdest.
- Bleib monatelang beim Lesen. Erst wenn die Antworten konstant stimmen und die Leute ihnen vertrauen, lohnt sich das Nachdenken über schreibende Vorgänge.
- Schreib nur über die Objekte, und protokolliere alles. Jeder Vorgang muss sich im Nachhinein einer Person und einem Werkzeug zuordnen lassen. Sonst bekommst Du bei der nächsten Prüfung ein Problem.
Was ich nicht glaube
Ein paar Erwartungen halte ich für falsch, und die sollte man aussprechen, bevor jemand ein Budget darauf aufbaut.
Dass das ERP verschwindet. Es wird unsichtbarer, aber jemand muss weiterhin Bestände führen, Belege nummerieren, Steuern richtig ausweisen und Bilanzen erzeugen. Diese Arbeit verschwindet nicht, sie wird nur seltener direkt angefasst.
Dass man sein Datenmodell nicht mehr verstehen muss. Das Gegenteil trifft zu. Ein Modell ist nur so gut wie die Struktur, auf die Du es lässt. Schlechte Stammdaten werden durch ein Sprachmodell nicht besser, sie werden schneller falsch beantwortet, und zwar in ganzen Sätzen, die sehr überzeugend klingen. Wer heute doppelte Artikel, falsche Warengruppen und einen mittleren Einkaufspreis von Hand überschreibt, bekommt später eben eine eloquent formulierte falsche Auskunft.
Dass das eine Frage der Version ist. Der begrenzende Faktor ist selten die Sage-Version, sondern die Frage, ob jemand die Geschäftslogik hinter der Oberfläche kennt und sauber ansprechen kann.
Was daraus folgt
Die Oberfläche ist nicht das Produkt. Das Datenmodell und die Geschäftslogik sind es. Wer beides sauber hält und über definierte Schnittstellen zugänglich macht, ist auf jede künftige Oberfläche vorbereitet, auch auf gar keine.
Das ist die eigentlich gute Nachricht für alle, die seit Jahren mit einer gewachsenen Sage 100 arbeiten: Die Investition der letzten fünfzehn Jahre steckt nicht in den Masken, sondern darunter. Sie bleibt nutzbar, wenn die Bedienung sich ändert. Vorausgesetzt, man hat die Datenqualität und die Schnittstellen im Griff, und daran führt so oder so kein Weg vorbei.
Wenn Du gerade überlegst, wie Du bei diesem Thema anfängst: Fang nicht beim Sprachmodell an. Fang bei den fünf Fragen an, die in Deinem Haus jede Woche Klickarbeit kosten, und bau dafür saubere Werkzeuge. Was am anderen Ende der Schnittstelle sitzt, kannst Du später immer noch austauschen.