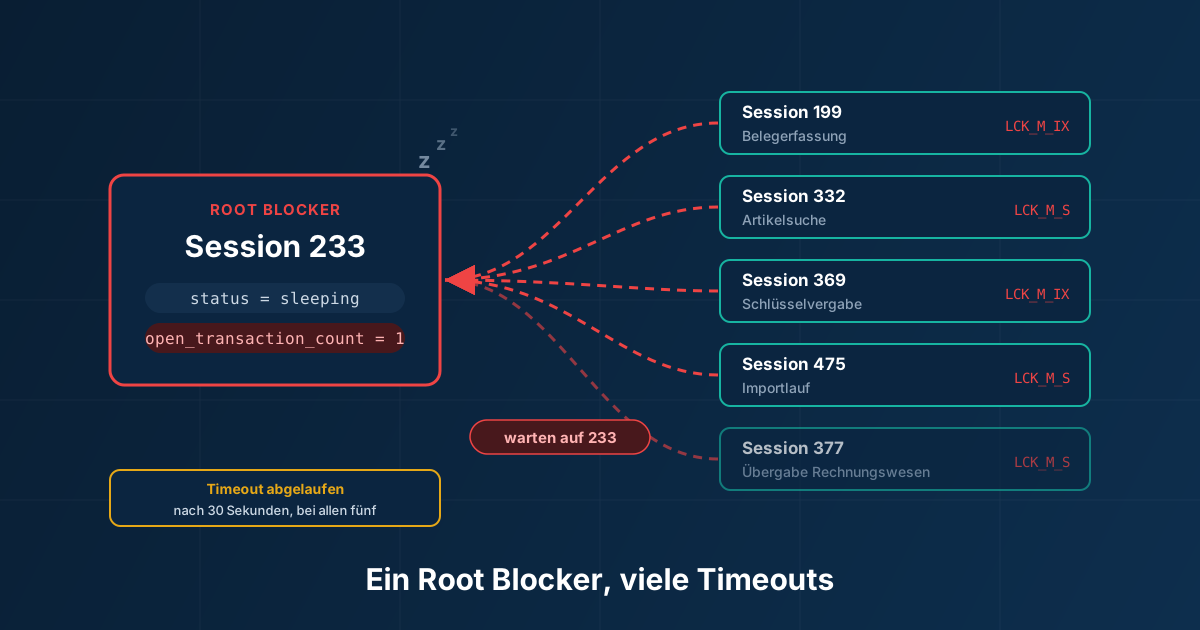
Freitagmittag, die Belegerfassung steht. In der Warenwirtschaft hängt die Maske beim Speichern, im Rechnungswesen lässt sich kein Beleg mehr öffnen, ein Importlauf im Hintergrund kommt nicht weiter. Nach einer halben Minute meldet die Sage 100: „Timeout abgelaufen. Das Timeout ist vor dem Beenden des Vorgangs eingetreten, oder der Server reagiert nicht." Der Server hat aber weder viel CPU-Last noch tut sich auf der Platte etwas. Er wartet. Und zwar auf eine einzige Session, die seit zehn Minuten nichts mehr tut.
Genau dieses Muster sehen wir regelmäßig, und fast immer läuft der erste Reflex in die falsche Richtung: Timeout hochsetzen, Server neu starten, Index neu aufbauen. In diesem Beitrag zeige ich Dir an einem Importdienst auf Basis des Sage 100 SDK, wie ein einziger fehlender Aufruf eine ganze Sage-100-Umgebung lahmlegt, wie Du den Verursacher in wenigen Minuten findest und was in eigener Programmierung anders laufen muss.
Was ein Timeout wirklich bedeutet
Der Timeout ist keine Entscheidung des SQL Servers. Er ist eine Entscheidung der Anwendung. Sie schickt einen Befehl, wartet die eingestellte Zeit (bei den meisten Datenzugriffsbibliotheken 30 Sekunden) und bricht dann ab. Der SQL Server bekommt davon nur ein sogenanntes Attention-Ereignis mit und beendet die Abfrage. Microsoft beschreibt den Ablauf in der Anleitung zum Behandeln von Abfragetimeoutfehlern und nennt dort als häufigsten Grund eine langsame Abfrage.
Es gibt aber einen zweiten Grund, der von außen exakt gleich aussieht: Die Abfrage ist überhaupt nicht langsam. Sie darf nur nicht anfangen, weil die Zeilen, die sie braucht, von einer anderen Transaktion gesperrt sind. Der SQL Server nennt das Blocking. Eine Sekunde Arbeit, 29 Sekunden Warten, dann der Abbruch. Wer in diesem Fall den Timeout auf 120 Sekunden stellt, erreicht nur, dass der Anwender zwei Minuten statt einer halben auf dieselbe Sperre wartet.
Die entscheidende Frage bei Timeouts lautet deshalb nicht „Wie erhöhen wir das Zeitlimit?", sondern „Wer blockiert wen, und warum hält diese Session ihre Transaktion so lange offen?"
Woran Du Blocking erkennst
Ein Blick in die aktuell laufenden Anforderungen zeigt bei Blocking mehrere Sessions mit Wartetypen wie LCK_M_S oder LCK_M_IX. Die Bedeutung ist in der Doku zu sys.dm_os_wait_stats beschrieben: LCK_M_S heißt, eine Session wartet auf eine Lesesperre (Shared Lock). LCK_M_IX heißt, eine Session will schreiben und wartet auf eine Intent-Exclusive-Sperre. Beides bekommt sie nicht, solange eine andere Transaktion die exklusive Sperre auf denselben Zeilen hält.
Und diese Sperren halten lange. Aus dem Handbuch zu Sperren und Zeilenversionsverwaltung: Eine Transaktion hält für jede Datenänderung eine exklusive Sperre, und zwar bis die Transaktion abgeschlossen ist, unabhängig von der Isolationsstufe. Solange also kein COMMIT oder ROLLBACK kommt, bleibt jede geänderte Zeile für alle anderen tabu. Lesen inklusive.
Aus den Wartenden entsteht dann eine Kette, die sich bis zu einem Verursacher zurückverfolgen lässt:
Session 233        <-- Root Blocker
├── Session 199    Belegerfassung, wartet LCK_M_S
├── Session 332    Artikelsuche, wartet LCK_M_S
├── Session 369    Schlüsselvergabe sysTan, wartet LCK_M_IX
│   └── Session 165
├── Session 377    Übergabe Rechnungswesen
└── Session 475    Importlauf
    └── Session 365
Session 233 ist der Root Blocker. Sie wartet selbst auf niemanden. Die anderen warten alle, direkt oder über einen Zwischenschritt, auf sie. Wer 369 oder 475 abschießt, hat nichts gewonnen, denn die Sperren liegen bei 233.
Der Fall: Ein Auftragsimport bleibt mitten in der Transaktion hängen
Das Beispiel ist an die Schulungsbeispiele aus dem Sage Developer-Programm angelehnt, mit denen Sage das Objektmodell des SDK erklärt. Ein Windows-Dienst holt Bestellungen aus dem Webshop als XML-Dateien ab und legt daraus Verkaufsaufträge in der Sage 100 an. Dazu meldet er sich beim Start einmal an der Sage 100 an und behält Session und Mandant, bis er beendet wird:
var session = ApplicationEngine.CreateSession("OLDemo", ApplicationToken.AddOn,
    null, new NamePasswordCredential("Import", passwort));
var mandant = session.CreateMandant(123);
Pro Bestellung erzeugt er über die BelegEngine einen Auftrag, schreibt danach die Shop-Bestellnummer mit der neuen BelID in eine eigene Zuordnungstabelle, hängt einen Protokolleintrag an und meldet die Auftragsnummer per REST an den Shop zurück. Damit Beleg und Zuordnung nur gemeinsam gespeichert werden, klammert der Entwickler alles in eine Transaktion auf der Verbindung des Mandanten. Genau das machen auch die Sage-Beispiele beim Lagerbuchungsimport, dort mit dem Kommentar „Transaktion pro Datei":
public void ImportiereBestellung(Mandant mandant, XMLBeleg xml)
{
    var conn = mandant.MainDevice.GenericConnection;
    conn.BeginTransaction();
    try
    {
        using (var beleg = new Beleg(mandant, Erfassungsart.Verkauf))
        {
            var jahr = (short)mandant.PeriodenManager.Perioden
                .Date2Periode(xml.Belegdatum).Jahr;
            beleg.Initialize("VVA", xml.Belegdatum, jahr);
            beleg.SetKonto(xml.EmpfaengerKonto, false);

            foreach (var p in xml.Positionen)
            {
                var pos = new BelegPosition(beleg);
                pos.Initialize(Positionstyp.Artikel);
                pos.SetArtikel(p.Artikelnummer, 0);
                pos.Menge = p.Menge;
                pos.Calculate();
                beleg.Positionen.Add(pos);
            }

            beleg.Calculate(true);
            beleg.Renumber();
            if (!beleg.Validate(true) || !beleg.Save(false))
                throw new BelegImportException(beleg.Errors.GetDescriptionSummary());

            SchreibeShopZuordnung(conn, xml.Bestellnummer, beleg.Handle);
            ProtokollHelper.AppendProtokollItem(mandant, ImportLog, beleg.Handle, ...);

            // REST-Aufruf an den Shop, noch innerhalb der Transaktion
            MeldeAuftragAnShop(xml.Bestellnummer, beleg.BelegnummerFormatiert);
        }
        conn.CommitTransaction();
    }
    catch (Exception ex)
    {
        TraceLog.LogException(ex);
        // Fehlt: conn.RollbackTransaction();
    }
}
Der catch-Block ist wörtlich aus dem Belegimport der Sage-Beispiele übernommen: Loggen und mit der nächsten Datei weitermachen. Dort ist das richtig, weil der Beispielimport keine eigene Transaktion aufmacht und die BelegEngine ihre Speicherung selbst absichert. Sobald aber eine eigene Klammer mit BeginTransaction dazukommt, fehlt in diesem catch der RollbackTransaction. Im Lagerbuchungsbeispiel von Sage steht er drin. Hier nicht.
Monatelang fällt das nicht auf. Dann ist der Shop eines Vormittags für zwanzig Minuten nicht erreichbar, der REST-Aufruf wirft eine Exception, sie wird geloggt, der Dienst nimmt sich die nächste Datei. Die Verbindung gehört dem Mandanten und lebt so lange wie der Dienst. Die Transaktion bleibt offen, weil niemand sie zurückrollt. Und der Auftrag ist zu diesem Zeitpunkt bereits vollständig geschrieben: Beleg.Save hat Belegkopf, Positionen und Vorgang angelegt und die Schlüssel dafür über sysTan aus KHKTan geholt. Alles gesperrt, nichts committet.
Zur Abgrenzung: Die Sage 100 hat eigene Sperren auf Anwendungsebene. Wer einen Beleg in der Erfassung offen hat, hält über den Mehrbenutzerdienst eine Semaphore, und der nächste bekommt „Beleg in Bearbeitung" angezeigt. Das ist gewollt und sichtbar. SQL-Blocking dagegen zeigt keine Meldung. Die Maske steht einfach, bis der Timeout kommt.
Was auf dem Server zurückbleibt
Auf dem SQL Server sieht Session 233 jetzt so aus:
session_id              233
status                  sleeping
open_transaction_count  1
last_request_end_time   10:14:04
Der Status sleeping bedeutet laut Doku zu sys.dm_exec_sessions schlicht, dass die Session gerade keine Anforderung ausführt. Sie verbraucht keine CPU, sie liest nichts, sie taucht in keiner Liste der laufenden Abfragen auf. Trotzdem hält sie exklusive Sperren auf jeder Zeile, die sie in der offenen Transaktion geändert hat: KHKVKBelege, KHKVKBelegePositionen, KHKVKVorgaenge, KHKVKVorgaengePositionen, die Zuordnungstabelle, das Protokoll und die Schlüsselzeilen in KHKTan.
KHKTan ist der Knackpunkt. Der einzelne Auftrag interessiert vielleicht nur den Vertrieb. Über KHKTan vergibt die Sage 100 aber per sysTan die Primärschlüssel für ihre Tabellen. Solange Session 233 die Zeilen für Belege und Positionen exklusiv hält, wartet jeder, der in diesem Mandanten einen Verkaufsbeleg anlegen will, auf sie. Und die tut nichts, außer zu schlafen.
| Uhrzeit | Was passiert |
|---|---|
| 10:14:02 | Der Importdienst (Session 233) beginnt die Transaktion. Beleg.Save schreibt Belegkopf, Positionen und Vorgang und holt die Schlüssel aus KHKTan. Auf allen Zeilen liegen jetzt exklusive Sperren. |
| 10:14:04 | Der REST-Aufruf an den Shop wirft eine Exception. Wird geloggt, kein RollbackTransaction. Die Session bleibt mit offener Transaktion im Status sleeping. |
| 10:14:20 | Ein Kollege sucht in der Auftragsübersicht. Sein SELECT auf KHKVKBelege wartet mit LCK_M_S. |
| 10:14:25 | Die Belegerfassung braucht über sysTan einen neuen Primärschlüssel. Das UPDATE auf KHKTan wartet mit LCK_M_IX. |
| 10:14:50 | Erster Anwender bekommt nach 30 Sekunden den Timeout. |
| 10:16:00 | Der Admin schaut auf den Server und sieht viele wartende Abfragen. Auf den ersten Blick sieht alles nach „Datenbank langsam" aus. |
| 10:16:30 | Blocking-Analyse: Alle Wartenden zeigen auf 233. Status sleeping, eine offene Transaktion seit zweieinhalb Minuten. Ursache gefunden. |
Warum der letzte Befehl so harmlos aussieht
Hier tappen viele in eine Falle. Wer nachsieht, was Session 233 zuletzt geschickt hat, findet oft etwas völlig Harmloses. Der Dienst hat sich nach dem Fehler die nächste Datei vorgenommen, und das Erste, was die BelegEngine dafür auf derselben Verbindung tut, ist ein Lookup:
SELECT ... FROM KHKKontokorrent WHERE Mandant = 123 AND Kto = 'D10001'Wie soll dieser SELECT sieben Tabellen sperren? Gar nicht. Die Sperren stammen von den INSERTs davor, die alle zur selben, noch offenen Transaktion gehören. Und es kommt schlimmer: Weil die Verbindung dieselbe ist, laufen auch alle folgenden Importe in dieser Transaktion weiter. Ein inneres COMMIT beendet in SQL Server keine äußere Transaktion, es zählt laut Doku zu COMMIT TRANSACTION nur @@TRANCOUNT um eins herunter. Jeder weitere Auftrag vergrößert also den Berg an Sperren, statt ihn abzubauen. Der Eingabepuffer zeigt Dir nur den letzten Befehl der Session, nicht den, der die Sperren erzeugt hat. Für den Blick in den Puffer gibt es seit SQL Server 2014 SP2 die Funktion sys.dm_exec_input_buffer, die das ältere DBCC INPUTBUFFER ablöst und sich per CROSS APPLY mit den Sessions verbinden lässt. Nutze sie als Hinweis auf die Anwendung, nicht als Beweis für den Verursacher.
So findest Du den Root Blocker
Vier Fragen führen zum Ziel: Wer blockiert wen? Ist auf der blockierenden Session eine Transaktion offen? Seit wann? Und welche Sperren hält sie? Für alle vier reichen die Systemsichten des SQL Servers, Du brauchst nur die Berechtigung VIEW SERVER STATE.
Schritt 1, die Wartenden. Alle Anforderungen, die auf eine andere Session warten, sortiert nach Wartezeit:
SELECT r.session_id,
       r.blocking_session_id,
       r.wait_type,
       r.wait_time / 1000 AS WartetSekunden,
       DB_NAME(r.database_id) AS Datenbank,
       t.text AS SqlText
FROM sys.dm_exec_requests AS r
OUTER APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.blocking_session_id <> 0
ORDER BY r.wait_time DESC;
Die Spalte blocking_session_id ist der Faden, an dem Du ziehst. Der Root Blocker ist die Session, die dort auftaucht, selbst aber auf niemanden wartet. Und jetzt der Punkt, an dem viele hängen bleiben: Session 233 steht in dieser Liste gar nicht drin. Sie führt keine Anforderung aus, also hat sie in sys.dm_exec_requests keine Zeile. Du siehst nur ihre Nummer bei den anderen.
Schritt 2, die Session dahinter. Wer ist das, von welchem Rechner, mit welchem Programm, und steht eine Transaktion offen?
SELECT s.session_id,
       s.status,
       s.login_name,
       s.host_name,
       s.program_name,
       s.open_transaction_count,
       s.last_request_start_time,
       s.last_request_end_time,
       c.client_net_address,
       ib.event_info AS LetzterBefehl
FROM sys.dm_exec_sessions AS s
LEFT JOIN sys.dm_exec_connections AS c ON c.session_id = s.session_id
OUTER APPLY sys.dm_exec_input_buffer(s.session_id, NULL) AS ib
WHERE s.session_id = 233;
Die Kombination aus status = sleeping und open_transaction_count > 0 ist das Signal. Eine Session, die nichts tut, aber eine Transaktion hält. Microsoft führt genau diese Suche als Beispiel in der Doku zu sys.dm_exec_sessions unter „Find idle sessions that have open transactions". host_name und program_name verraten Dir, welcher Arbeitsplatz und welche Anwendung dahinterstecken. Bei einem Importdienst steht dort ein anderer Rechner und ein anderer Programmname als beim Sage-Client, das grenzt den Kreis der Verdächtigen sofort ein.
Schritt 3, das Alter der Transaktion.
SELECT st.session_id,
       at.transaction_id,
       at.name,
       at.transaction_begin_time,
       DATEDIFF(SECOND, at.transaction_begin_time, GETDATE()) AS OffenSeitSekunden,
       at.transaction_state
FROM sys.dm_tran_session_transactions AS st
JOIN sys.dm_tran_active_transactions AS at ON at.transaction_id = st.transaction_id
WHERE st.session_id = 233;
Ein transaction_state von 2 heißt laut Doku zu sys.dm_tran_active_transactions: Die Transaktion ist aktiv. Zusammen mit transaction_begin_time weißt Du, ob es um Sekunden geht (normal) oder um Minuten (verwaist).
Schritt 4, die gehaltenen Sperren. Auf welchen Tabellen liegt die Session?
SELECT DISTINCT
       tl.resource_type,
       tl.request_mode,
       tl.request_status,
       OBJECT_SCHEMA_NAME(p.object_id, tl.resource_database_id) AS Schema_,
       OBJECT_NAME(p.object_id, tl.resource_database_id) AS Tabelle
FROM sys.dm_tran_locks AS tl
LEFT JOIN sys.partitions AS p ON p.hobt_id = tl.resource_associated_entity_id
WHERE tl.request_session_id = 233
  AND tl.resource_database_id = DB_ID('OLDemo')
ORDER BY Tabelle, tl.request_mode;
Hier tauchen sie auf: KEY-Sperren im Modus X auf KHKVKBelege, KHKVKBelegePositionen, KHKVKVorgaenge, KHKVKVorgaengePositionen, KHKTan und der Zuordnungstabelle des Importdienstes. Damit hast Du den Beweis, dass die Sperren nicht vom harmlosen letzten SELECT stammen, sondern von Schreibzugriffen davor.
Wer das nicht jedes Mal von Hand zusammensetzen will, nimmt sp_WhoIsActive von Adam Machanic. Die Prozedur ist seit Jahren der Standard in der SQL-Server-Community, kostenlos, und zeigt Blocking-Ketten samt offenen Transaktionen in einem einzigen Aufruf.
Akut: Die Session beenden
Wenn klar ist, dass die Transaktion verwaist ist, löst ein KILL 233 die Blockade. Der SQL Server beendet dabei nicht einfach die Verbindung. Er rollt die offene Transaktion zurück, und das kann laut Doku zu KILL dauern, je nachdem, wie viel Arbeit rückgängig zu machen ist. Den Fortschritt siehst Du mit KILL 233 WITH STATUSONLY, das nur den Stand des Rollbacks in Prozent anzeigt und selbst nichts beendet. Wiederhole niemals das nackte KILL 233, um den Fortschritt zu prüfen: Sobald der Rollback fertig ist, kann die Session-Nummer an eine neue Verbindung vergeben werden, und Du triffst den Falschen. Auch das steht so in der Doku.
Vor dem KILL gehören drei Dinge geklärt, weil ein Rollback nicht rückgängig zu machen ist:
- Welcher Anwender und welcher Arbeitsplatz stecken dahinter? Bei der Sage 100 hält der Client seine Verbindung dauerhaft. Ein KILL trifft also einen echten Menschen, dessen Sage 100 danach die Verbindung verliert.
- Welcher Geschäftsvorgang wird zurückgerollt? Im Beispiel verschwindet der halb erzeugte Beleg. Das ist hier gewollt, muss aber jemand wissen.
- Ist die Transaktion wirklich verwaist, oder läuft da ein legitimer, nur langer Vorgang wie ein Jahresabschluss oder ein Importlauf?
Deep Dive Warum die Verbindung im Beispiel nie geschlossen wird
Ein häufiger Einwand lautet: „Wenn die Verbindung geschlossen wird, rollt der SQL Server doch alles zurück." Das stimmt. Das Sperrhandbuch von Microsoft sagt ausdrücklich, dass bei einem Verbindungsabbruch, einem Absturz des Clients oder einem Neustart des Rechners alle ausstehenden Transaktionen zurückgerollt werden. Und die Doku zu SqlConnection.Close ergänzt: Close rollt jede ausstehende Transaktion zurück und gibt die Verbindung dann an den Pool zurück. Bei aktivem Connection Pooling passiert der Rollback beim Zurücksetzen der Verbindung.
Das Problem im Beispiel ist, dass keiner von beiden Fällen eintritt. Im Sage 100 SDK gehört die Verbindung nicht Deinem Code, sondern dem Mandanten. Du bekommst sie über MainDevice.GenericConnection nur geliehen. Der Mandant lebt so lange wie die Session, und ein Dienst oder ein AddIn im Sage-Client meldet sich einmal an und erst beim Beenden wieder ab. Ein Rollback durch Verbindungsende kommt also erst, wenn jemand den Dienst neu startet. Das ist übrigens der Grund, warum „nach dem Neustart ging es wieder" so oft die einzige Beobachtung ist, die vom Vorfall übrig bleibt. Wer stattdessen eigene ADO.NET-Verbindungen aufmacht, hat die gleiche Pflicht in eigener Hand: Eine SqlConnection, die den Gültigkeitsbereich verlässt, wird laut Doku nicht geschlossen. Du musst Close oder Dispose selbst aufrufen.
Es gibt noch eine zweite Wirkung nicht geschlossener Verbindungen, die gern mit dem Blocking verwechselt wird: Der Pool läuft voll. Laut Doku zum Connection Pooling sind standardmäßig 100 Verbindungen pro Pool erlaubt. Werden sie nicht zurückgegeben, wartet der nächste Open-Aufruf 15 Sekunden und wirft dann ebenfalls einen Timeout, diesmal beim Verbinden statt beim Ausführen. Beide Fehler heißen für den Anwender „Timeout", haben aber verschiedene Ursachen. Der Beitrag von Microsoft zu Abfragetimeouts erklärt, wie Du die beiden auseinanderhältst.
Wie es richtig geht
Die Mindestanforderung: Jede begonnene Transaktion endet mit Commit oder Rollback, auch im Fehlerfall. Sages eigene Beispiele zeigen das Muster beim Löschen von Protokolleinträgen und beim Lagerbuchungsimport: BeginTransaction, Arbeit, CommitTransaction, und im catch zuerst RollbackTransaction, dann loggen, dann die Exception weiterreichen. Der zweite Punkt ist genauso wichtig: Der REST-Aufruf gehört hinter das Commit.
public void ImportiereBestellung(Mandant mandant, XMLBeleg xml)
{
    var conn = mandant.MainDevice.GenericConnection;
    string belegnummer;

    conn.BeginTransaction();
    try
    {
        using (var beleg = new Beleg(mandant, Erfassungsart.Verkauf))
        {
            // Initialize, SetKonto, Positionen, Calculate, Renumber wie oben

            if (!beleg.Validate(true) || !beleg.Save(false))
                throw new BelegImportException(beleg.Errors.GetDescriptionSummary());

            SchreibeShopZuordnung(conn, xml.Bestellnummer, beleg.Handle);
            ProtokollHelper.AppendProtokollItem(mandant, ImportLog, beleg.Handle, ...);
            belegnummer = beleg.BelegnummerFormatiert;
        }
        conn.CommitTransaction();
    }
    catch
    {
        conn.RollbackTransaction();
        throw;
    }

    // Ab hier sind alle Sperren frei.
    MeldeAuftragAnShop(xml.Bestellnummer, belegnummer);
}
Innerhalb einer Datenbanktransaktion passiert nur Datenbankarbeit. Kein Webservice, kein PDF, kein Drucker, keine E-Mail, kein Dialog, der auf den Anwender wartet. Alles davon kann langsam sein oder scheitern, und jede Sekunde davon ist eine Sekunde, in der Deine Sperren die Kollegen aufhalten. Wenn der Shop nach dem Commit nicht erreichbar ist, merkst Du Dir die Rückmeldung als offen und holst sie beim nächsten Lauf nach. Das ist ein fachliches Problem, kein Sperrproblem.
Der Unterschied ist nicht akademisch. Eine Variante, die wir in der Praxis gesehen haben: Ein Webservice-Aufruf mitten in der Transaktion, der normalerweise 200 Millisekunden dauert. An dem Tag, an dem der Anbieter Wartungsarbeiten hatte, dauerte er 90 Sekunden. 90 Sekunden, in denen jede Belegerfassung im Haus stand. Der SQL Server war dabei komplett unschuldig.
Das gilt auch für DCMs in der Sage 100
Der Importdienst arbeitet von außen gegen die BelegEngine. Wer die Belegerfassung stattdessen von innen erweitert, sitzt noch näher an der Transaktion: Das Ereignis wird im AppDesigner registriert, die Implementierung dahinter ist ein DCM. Die Sage-Doku zu den Erweiterungen der Belegerfassung ist da eindeutig: Die DCMs VKBelegProxyBeforeSave und VKBelegProxyAfterSave werden vor beziehungsweise nach der Transaktion ausgeführt. VKBelegBeforeSave und VKBelegSave laufen mittendrin. Dasselbe steht in der Doku zu den Ereignissen, die im AppDesigner registriert werden: Das Ereignis vor Änderung eines Datensatzes wird serverseitig innerhalb der Transaktion ausgeführt.
Für Dich heißt das: Alles, was ein DCM für VKBelegSave, VKBelegBeforeSave oder das Ereignis vor Änderung eines Datensatzes implementiert, verlängert die Zeit, in der die Sage 100 ihre Sperren auf Belegkopf, Positionen und KHKTan hält. Ein Aufruf ins DMS, eine Adressprüfung bei einem Webdienst, ein Etikettendruck oder ein Mailversand an dieser Stelle bremst nicht nur diesen einen Anwender, sondern jeden, der gerade einen Beleg speichern will. Solche Dinge gehören in VKBelegProxyAfterSave, wenn die Transaktion abgeschlossen ist. In der Transaktion bleibt nur, was wirklich mit dem Beleg zusammen gespeichert oder verworfen werden muss.
Deep Dive Weitere Verursacher, die genauso aussehen
Das vergessene Query-Fenster. Der Klassiker. Jemand testet im Management Studio ein UPDATE mit BEGIN TRAN, um es notfalls zurückrollen zu können, geht in die Mittagspause und lässt das Fenster offen. Session sleeping, Transaktion offen, Programmname SQL Server Management Studio. Kommt öfter vor, als man denkt.
Implizite Transaktionen. Mit SET IMPLICIT_TRANSACTIONS ON startet der SQL Server bei jedem Datenzugriff automatisch eine Transaktion, die erst mit einem ausdrücklichen COMMIT endet. Manche Treiber und Tools setzen das ein, wenn Autocommit abgeschaltet wird. Die Anwendung glaubt, sie hätte gar keine Transaktion offen. Hat sie aber.
Trigger. Ein einzelnes UPDATE auf eine Tabelle kann über Trigger weitere Tabellen ändern. Alle diese Änderungen gehören zur selben Transaktion und halten ihre Sperren genauso lange. Wer sich wundert, warum eine Session Sperren auf Tabellen hält, die sie nie direkt angefasst hat, sollte in sys.triggers nachsehen. Bei der Sage 100 gilt das auch für Trigger, die Zusatzmodule oder Schnittstellen auf Sage-Tabellen legen.
Benutzerinteraktion in der Transaktion. Transaktion starten, Datensatz ändern, Dialog anzeigen „Wirklich buchen?" und auf den Klick warten. Wenn der Anwender jetzt telefoniert, wartet die halbe Firma mit. Das Sperrhandbuch von Microsoft legt die Verantwortung dafür ausdrücklich in die Hand der Anwendung.
Beim nächsten Mal nicht mehr suchen müssen
Blocking hat eine unangenehme Eigenschaft: Wenn Du hinschaust, ist es oft schon vorbei. Der Anwender hat seine Sage 100 neu gestartet, die Verbindung ist weg, die Transaktion ist zurückgerollt, die Kette hat sich aufgelöst. Damit Du beim nächsten Mal nicht auf Verdacht suchen musst, kann der SQL Server Blocking selbst melden. Die Serveroption blocked process threshold legt fest, ab wie vielen Sekunden Wartezeit ein Bericht erzeugt wird. Zulässig sind 5 bis 86.400 Sekunden, standardmäßig ist die Option aus.
EXEC sp_configure 'show advanced options', 1;
RECONFIGURE;
EXEC sp_configure 'blocked process threshold', 20;
RECONFIGURE;
Den Bericht fängst Du mit einer Extended-Events-Sitzung auf das Ereignis blocked_process_report ab. Er enthält beide Seiten, den Blockierten und den Blockierer, samt Eingabepuffer und offener Transaktionsdauer. Damit hast Du morgens die Antwort auf die Frage, was gestern Nachmittag los war, ohne dass jemand im richtigen Moment am Server sitzen musste. Wichtig aus der Doku: Der Sperrmonitor prüft nur alle fünf Sekunden, kürzere Blockaden werden nicht erkannt, und der Bericht ist nicht in Echtzeit garantiert. Für die Ursachensuche reicht das völlig.
Fazit
Ein Timeout ist ein Symptom. Ob dahinter eine langsame Abfrage oder eine blockierende Transaktion steckt, entscheidet über die Therapie, und die zweite Ursache ist tückischer, weil der Verursacher im Status sleeping unsichtbar bleibt. Vier Fragen bringen Dich hin: Wer blockiert wen, ist eine Transaktion offen, seit wann, und welche Sperren hält sie. Die Antworten stehen alle in den Systemsichten des SQL Servers.
Passend dazu: Unser SQL-Performance-Test für die Sage 100 zeigt Dir mit den Lock-Hotspots, an welchen Tabellen sich Deine Anwender tatsächlich stauen. Und was passiert, wenn sich zwei Transaktionen gegenseitig blockieren, erklärt der Beitrag zu Deadlocks im SQL Server.
Anpassungen, die auch unter Last halten
Wenn bei Dir gerade Belege hängen und niemand weiß, warum, finden wir den Root Blocker. Meist dauert das weniger lang als die Diskussion über den Timeout-Wert. Der eigentliche Wert liegt aber davor: Die meisten Blocking-Fälle, die wir sehen, stammen aus eigener Programmierung rund um die Sage 100, aus Diensten und AddIns, aus DCMs hinter registrierten Ereignissen, aus Schnittstellen zu Shop, DMS oder Zeiterfassung. Im Test mit zwei Anwendern läuft das alles. Mit vierzig Anwendern an einem Monatsende nicht mehr.
Deshalb prüfen wir solche Anpassungen auf das, was im Produktivbetrieb zählt: Werden Transaktionen sauber beendet, auch im Fehlerfall? Sind sie so kurz wie möglich? Stecken externe Aufrufe oder Dialoge in einer offenen Transaktion oder in einem DCM, das innerhalb der Transaktion läuft? Werden Verbindungen zurückgegeben? Greifen alle Abläufe in derselben Reihenfolge auf die Sage-Tabellen zu? Und wir lassen das Ganze unter realistischer Last laufen, bevor es Deine Anwender tun. Egal ob die Anpassung von uns stammt, von einem anderen Partner oder aus dem eigenen Haus.